Fabian Georgi · ·Überarbeitet: ·Architektur
EPoSe im Betrieb: Zustandskopien, Änderungsjournale und belastbare Nachweise
EPoSe (Egalitarian Proof of Service) im Betrieb: Änderungsjournale statt Zustandskopien und getrennte Belege für Tests, Speicherbedarf, CI und Canary.
Ein Protokoll kann richtige Ergebnisse liefern und trotzdem im Dauerbetrieb zu teuer werden. Seine Historie wächst, Rücknahmen müssen möglich bleiben, und eine einfache Transaktionsstrategie vervielfacht unbemerkt die gehaltenen Daten. Wie lässt sich der Speicherbedarf reduzieren, ohne den kanonischen Zustand oder die Auszahlung eines einzigen Blocks zu verändern?
Im letzten Teil meiner Fallstudie zum EPoSe-Entwicklungsauftrag für Qwertycoin gehören Korrektheit und Betreibbarkeit deshalb zusammen. Grundlage sind die frühere Undo-/Replay-Konstruktion und die dokumentierte Speicherarbeit in PR #228. Die dort berichteten Core-Tests und Messungen werden hier eingeordnet; ich habe sie für diesen Website-Beitrag nicht erneut ausgeführt.
Warum vollständige Kopien zunächst attraktiv sind
Bei einem Block mit mehreren Transaktionen darf ein Fehler nicht nur die letzte Änderung zurücknehmen. Auch ein zuvor gültiger Record und ein bereits eingefrorener Snapshot müssen verschwinden, wenn der ganze Block abgelehnt wird. Die einfache Strategie lautet: Kopie herstellen, darauf arbeiten, bei Erfolg übernehmen. Bei einem Fehler bleibt der alte Zustand unangetastet.
Die Baseline behält bis zu 2.160 vollständige semantische Vorzustände für den Undo-Horizont. Gleichzeitig wächst die enthaltene Historie: Lifecycle-Einträge früherer Identitäten und Deskriptoren, Admission-Leases, Receipt-Metadaten, Mitgliedschafts-Snapshots und geschlossene Qualifikationen. Zusätzliche Block- und Transaktionskandidaten können weitere vollständige Zustände gleichzeitig halten.
Die Anzahl der Undo-Einträge ist begrenzt, ihr jeweiliger Inhalt aber nicht konstant. Der relevante Befund ist deshalb gehaltene Historie mit Kopiervervielfachung, nicht ein nachgewiesenes klassisches Speicherleck aus unerreichbaren Allokationen.
Für einen gefüllten Undo-Horizont lässt sich der Effekt bewusst vereinfacht modellieren:
W = 2160
H(h) ist die Speichergröße des historischen Zustands bei Höhe h, T(h) der temporäre Zusatzbedarf. Die Formel beschreibt diese EPoSe-Anteile, nicht den gesamten Prozess-RSS. RSS (Resident Set Size) misst residente Prozessseiten und umfasst weitere Komponenten, etwa den RandomX-Cache und Allokator-Effekte.
Statt des ganzen Zustands die Änderung aufheben
PR #228 ersetzt die gehaltenen Vollzustände durch Änderungsjournale. Die Idee ist nicht, Historie zu löschen, sondern die Rücknahmeinformation auf die tatsächlichen Änderungen zu begrenzen:
- Bei appendierenden Containern wird die frühere Länge gespeichert. Undo kürzt auf diese Länge zurück.
- Bei ersetzten Leases werden der vorherige Wert und seine Aufnahmehöhe festgehalten.
- Für geänderte Lifecycle-Historien merkt sich das Journal deren alte Länge.
- Neu eingefügte Snapshot- und Qualifikationsschlüssel werden beim Undo entfernt.
- Frühere Tip-Metadaten stellen den Bezug zum Parent wieder her.
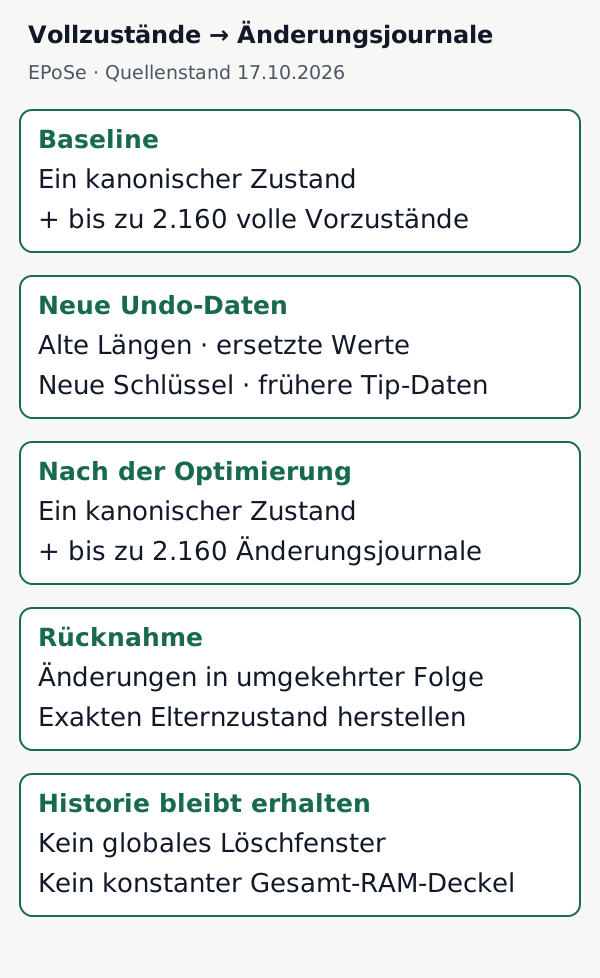
Damit wird aus dem Kopiermodell:
J bezeichnet die Größe der protokollierten Änderungen. Der aktuelle historische Zustand H bleibt vorhanden. Auch T′ ist nicht null: Hash-Serialisierung, isolierte Vorschauzustände, Sonderpfade und ein gleichzeitiger alter und neuer Coordinator während eines sicheren Rebuilds benötigen weiterhin Speicher. Das Modell garantiert keinen konstanten Gesamtverbrauch.
Zusätzlich entfernt die Änderung redundante semantische Kopien in Relay-Prüfungen und Template-Auswahl. Bei der Zustands-Hashbildung werden Zeigersichten sortiert, statt historische Lease-/Receipt-Werte vollständig zu kopieren. Die kanonisch serialisierten Bytes und ihre Reihenfolge bleiben dabei unverändert; der temporäre Hash-Puffer kann trotzdem mit der Historie wachsen.
Die schwierigen Fälle liegen zwischen den Änderungen
Ein Journal ist nur hilfreich, wenn es jeden begonnenen Übergang korrekt rückgängig machen kann. Eine nichtleere Transaktion bekommt dafür einen verschachtelten Checkpoint. Scheitert sie nach einem gültigen Präfix oder durch eine Ausnahme, stellt ein Scope Guard diesen Checkpoint wieder her. Bei Erfolg werden die Journal-Einträge in das Blockjournal übernommen; die nötigen Reservierungen erfolgen vorher.
Scheitert eine spätere Transaktion, muss das äußere Blockjournal auch frühere erfolgreiche Transaktionen zurücknehmen. Änderungen an Epochengrenzen zählen genauso: Ein Block ohne normale Records kann Mitgliedschaft einfrieren oder Qualifikation schließen und braucht deshalb ebenfalls Undo-Daten. Leere Record-Listen überspringen nicht die ursprünglichen Konfigurations- und Höhenprüfungen.
Besonders leicht zu übersehen ist ein gefülltes Undo-Fenster. Der älteste gültige Eintrag darf erst nach Annahme des neuen Blocks verdrängt werden. Ein abgelehnter Block darf keinen bestehenden Rücknahmepfad verkürzen.
Die erste zentrale Invariante lautet für einen erfolgreich angewandten Block innerhalb des Undo-Horizonts:
Die zweite vergleicht alte und neue Implementierung für denselben kanonischen Chain-Präfix Cₕ:
Gemeint sind EPoSe-Zustands-Hashes, keine neue Definition des Blockhashs. Ein Reorg muss auf dem neuen Zweig zum selben Ergebnis führen wie ein frischer Replay dieses Zweigs. Außerhalb des begrenzten Undo-Fensters wird kanonischer Replay angefordert, nicht stillschweigend ein unvollständiger Zustand akzeptiert.
Warum acht Epochen noch kein Speicherdeckel sind
Die scheinbar einfachere Alternative wäre, nur die aktuelle und sieben ältere Epochen zu behalten. Das würde aber den bestehenden Zustand verändern: Alle fünf historischen Containerarten gehen in seine Bindung ein. Alte Deskriptoren können weiterhin wirksam sein, historische Schlüsselintervalle betreffen oder die Zuordnung eines Rewards erklären. Neue Leases können auf zukünftige Epochen zielen. Ein starres Alterslimit ist dafür keine hinreichende Löschregel.
Zwei verschiedene Fenster dürfen nicht verwechselt werden:
| Fenster | Bedeutung im gelesenen Stand |
|---|---|
| 2.160 Blöcke | Implementierter Undo-Horizont: drei Produktionsepochen à 720 Blöcke. |
| Aktuelle plus sieben ältere Epochen | Diskutierter künftiger Cache, kein implementiertes globales Löschfenster. |
LMDB hält bereits Chain-Daten und Zustandsbindungen in den kanonischen Schreibtransaktionen. Daraus folgt noch kein materialisierter historischer EPoSe-Index mit gezieltem Zugriff auf alle alten Lifecycle-, Receipt- und Qualifikationswerte. Startup und tiefer Replay können den Zustand aus der kanonischen Chain rekonstruieren und gegen die gespeicherten Bindungen prüfen.
Ein tatsächlich stärker begrenzter residenter Zustand braucht gesonderte Archiv-/Indexarbeit: versionierte Schlüssel- und Intervallindizes, atomare Updates und inverse Reorg-Operationen, generationstreue Caches und exakt dieselbe kanonische Serialisierung aus kalten Daten. Ein anderer inkrementeller Hash wäre nicht einfach dieselbe Optimierung. Diese Arbeit ist ein Ausblick, keine gelieferte Acht-Epochen-Garantie.
Auch freigegebene Objekte bedeuten nicht sofort weniger RSS. Äußere Vektoren können ihre bisherige Kapazität behalten, und Allokatoren können freigegebene Seiten zurückhalten. Die Payload-Diagnostik berücksichtigt Kapazitäten und Map-Werte, aber nicht sämtlichen Container-/Allokator-Overhead. Sie ist daher nicht mit Prozess-RSS gleichzusetzen.
Was die Tests tatsächlich belegen
Die folgende Tabelle fasst dokumentierte Ergebnisse von PR #228 am Head 254796c3aa6f48e91f4c5680eb27af017316ae5c zusammen, keine erneute Ausführung durch diese Redaktion:
| Evidenz | Dokumentiertes Ergebnis | Aussagegrenze |
|---|---|---|
| Fokussierte Suite am genannten Head | 282/282 bestanden | Die geprüften Fälle, einschließlich Journal-Regressionen. |
| Vergleich mit gepinnter Referenz v2.0.4 | 591 einzelne Zustands-Hashes identisch; 1.152 signierte Receipts; 36 Elternzustände wiederhergestellt | Synthetischer Vergleich über 32 verkürzte Testepochen. |
| Separater Undo-Stresstest | 6.480 Blöcke, 360 verkürzte Testepochen; voller 2.160-Block-Rollback geprüft | Nicht mit Produktionsepochen gleichsetzen. |
| Peak-RSS im synthetischen Vergleich | 343.304 → 275.820 KiB, etwa 19,7 % geringer | Ein Linux-Lauf; gemeinsamer RandomX-Cache beeinflusst das Ergebnis. |
| Laufzeit desselben Vergleichs | 33,375 → 34,340 Sekunden | Kein belegter Geschwindigkeitsgewinn. |
| CI zum dokumentierten Head | 7/7 Checks erfolgreich, einschließlich ASan und Windows-Prüfung | CI bleibt ein eigener Nachweis neben lokalem Build und Betrieb. |
| Einzelner Canary | Tip und EPoSe-Zustand bei Blockanzahl 23.910 mit drei weiteren Nodes gleich | Punktuelle Kompatibilität, kein Flottennachweis. |
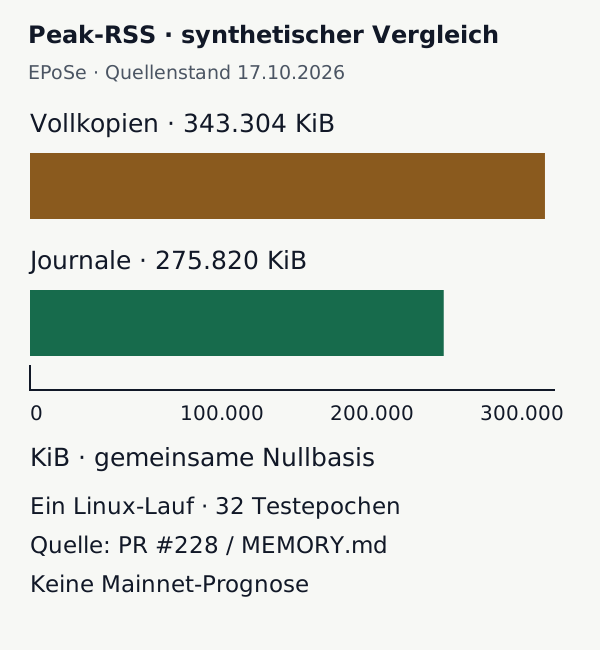
Die Probe verwendet 18-Block-Testepochen, echte signierte Records und deterministische Testdaten. 32 solcher Epochen füllen den 2.160-Block-Horizont nicht; dafür gibt es den getrennten 6.480-Block-Stresstest. Das Vergleichsprogramm misst den Peak jedes Kindprozesses separat und vergleicht die vollständige Zustands-Hash-Spur. So wird nicht nur ein gleiches Endergebnis behauptet.
Die Nullbasis und gemeinsame Einheit des Diagramms machen den gemessenen Unterschied sichtbar. Sie erlauben keine Hochrechnung auf einen Mainnet-Langzeitverlauf. Ebenso ist der erfolgreiche lokale Daemon-Build unter Speicherbeschränkung vom regulären Required-CI-Artefakt zu trennen: Lokal waren Build-only-Speicheranpassungen für drei unveränderte große Übersetzungseinheiten nötig; EPoSe und Probe behielten ihre regulären Optimierungsflags. Das ist weder ein Default-Release-Build-Nachweis für den gesamten lokalen Daemon noch ein Runtime-Fehlerbefund.
Der spätere Canary ergänzt den früheren Buildbericht
Die Speicheranalyse dokumentierte zunächst, dass bei diesem lokalen Build kein Produktionsdaemon verändert wurde. Der spätere PR-Bericht beschreibt zusätzlich einen autorisierten einzelnen Daemon-Canary auf exakt demselben genannten Head, mit Versionskennung 2.0.5. Verwendet wurde das checksumgebundene Daemon-Artefakt aus der regulären Required-CI, nicht der lokal speicherschonend gebaute Daemon.
Nach Startup und Replay sowie Verarbeitung eines weiteren Live-Blocks stimmten bei Blockanzahl 23.910 Tip und EPoSe-Zustand mit drei weiteren Nodes überein. Die damaligen Werte stehen im PR-Bericht. Das ist eine begrenzte Kompatibilitätsbeobachtung, keine Langzeitmessung. Betroffen war der Daemon, nicht ein vollständiger Austausch aller Wallet-Binaries.
Beim erneuten Quellenabruf am 17. Oktober ist PR #228 weiterhin offen. Der Canary ist kein veröffentlichtes stabiles 2.0.5-Release und kein flächendeckender Rollout. Die beiden zeitlich verschiedenen Berichte widersprechen sich nicht: Erst wurde gebaut und getestet, später ein begrenztes Artefakt betrieblich erprobt.
Was Telemetrie und Checkpoints zusätzlich sichtbar machen
Die in 2.0.4 dokumentierte Endpoint-Telemetrie meldet software_version, tip_height, tip_hash und synchronized des antwortenden lokalen Nodes. Sie ist nicht Bestandteil des signierten Endpoint-Deskriptors und kein Qualifikations- oder Konsensbeweis. Für eine Tip-Aussage muss ein unabhängiger Vergleich auf derselben Höhe erfolgen; verschiedene Tip-Höhen allein sind kein Beweis eines Forks.
Die Hauptbranch-Dokumentation führt außerdem Checkpoints bis Höhe 23.039. Aktualisierte Clients prüfen an solchen historischen Grenzen bekannte Blockhashes und kumulative Schwierigkeit. Welche Grenze gilt, hängt vom tatsächlich verwendeten Client ab; darüber bleibt die normale Chain-Auswahl relevant. EPoSe bekommt dadurch keine eigene Finalität.
Die dokumentierte Automatisierung erstellt nach Mehrquellenprüfungen Checkpoint-Vorschläge. Sie genehmigt oder veröffentlicht diese nicht selbstständig; DNS-Publikation bleibt im gelesenen Stand deaktiviert. Checkpoints ersetzen weder Änderungsjournale noch einen historischen Speicherindex.
Die gemeinsame Entwicklungsaufgabe
Aus „Tests bestanden“ folgt nicht automatisch „netzweit bewährt“. Umgekehrt wäre es unvollständig, einen später dokumentierten Canary hinter einem früheren Buildhinweis verschwinden zu lassen. Ich ordne deshalb Regeltests, Implementierungsvergleich, Speicherexperiment, CI und Betrieb jeweils ihrer konkreten Frage zu.
Die übertragbare Lehre dieser Arbeit ist, korrekte Ergebnisse, begrenzte Rücknahme, historische Nachvollziehbarkeit und tragbaren Ressourcenverbrauch gemeinsam zu entwerfen. Ein Journal kann die Vervielfachung beseitigen, ohne Historie zu löschen. Belastbar wird diese Entscheidung erst, wenn ihre Zustandsinvarianten und ihre Ressourcenaussagen getrennt überprüfbar bleiben.
Quellen und Stand
Inhaltlich geprüft am 17.10.2026. Hauptbranch: e2f7b6788dee6e065acc874daee3d4a085dbd9c8; veröffentlichtes v2.0.4: 1e479cc9feda48e07dd07ba6abcb89ca3934b5e2. Der frühere Quellenstand dieser Fallstudie war bc31e684dc365be5ed851b038b47d6f692d49a1e. Die neuere Hauptbranch-Dokumentation ist nicht automatisch der Stand jedes laufenden Nodes.
- docs/epose/MEMORY.md
- tests/unit_tests/epose_memory_probe.cpp
- tests/epose/memory_compare.py
- docs/MAINNET_CHECKPOINTS.md
- docs/epose/RPC.md
- Veröffentlichtes Release v2.0.4
- PR #228: Test- und späterer Canary-Bericht, beim Abruf offen; Head
254796c3aa6f48e91f4c5680eb27af017316ae5c. Dokumentierte Testergebnisse sind keine eigene erneute Core-Prüfung.